
 首页
 中心概况
 平台建设
 创新团队
 科研成果
 人才培养
 产业发展
 招贤纳士
 全国颠覆性技术创新






企业风采|容芯致远AGC-32F荣获创客中国、创客北京双奖
本文转载自“北京容芯致远科技有限公司”微信公众号
编者按
近日,京津冀国家技术创新中心和朝阳颠覆性技术创新中心联合培育的高科技企业北京容芯致远科技有限公司(简称“容芯致远”)凭借自主研发的“基于AGC创新架构体系设计的32卡超节点智算服务器”在两项行业赛事中连创佳绩,先后斩获第十一届“创客中国”高端科学仪器装备和传感器中小企业创新创业大赛企业组二等奖,以及“创客北京2026”软通动力·AI Infra产业链专项赛二等奖。
在容芯致远的AGC产品序列里,16F主打移动部署,万向轮一推就走,解决的是“算力到现场”的问题。64F是单机64卡的旗舰超节点,面向大规模训练和高密度推理。夹在中间的32F,容易被忽略,但它补的恰恰是一块很现实的空白。
很多项目在选型时会遇到一个尴尬:算力需求超过16卡,但现场没有液冷条件。标准机房不够用,小型机房里空调和配电又带不动高功耗设备。想上64卡超节点,条件不允许;用传统8卡方案堆叠,规模又不够,而且通信瓶颈会随卡数增加迅速恶化。
这不是个别现象。大量企业自建机房、高校实验室、中型推理服务团队,都卡在这个区间里。他们需要的不是旗舰设备,也不是入门设备,而是一台能在普通环境里稳定跑起来、算力规模刚好够用的机器。
32F就是为这个区间设计的。
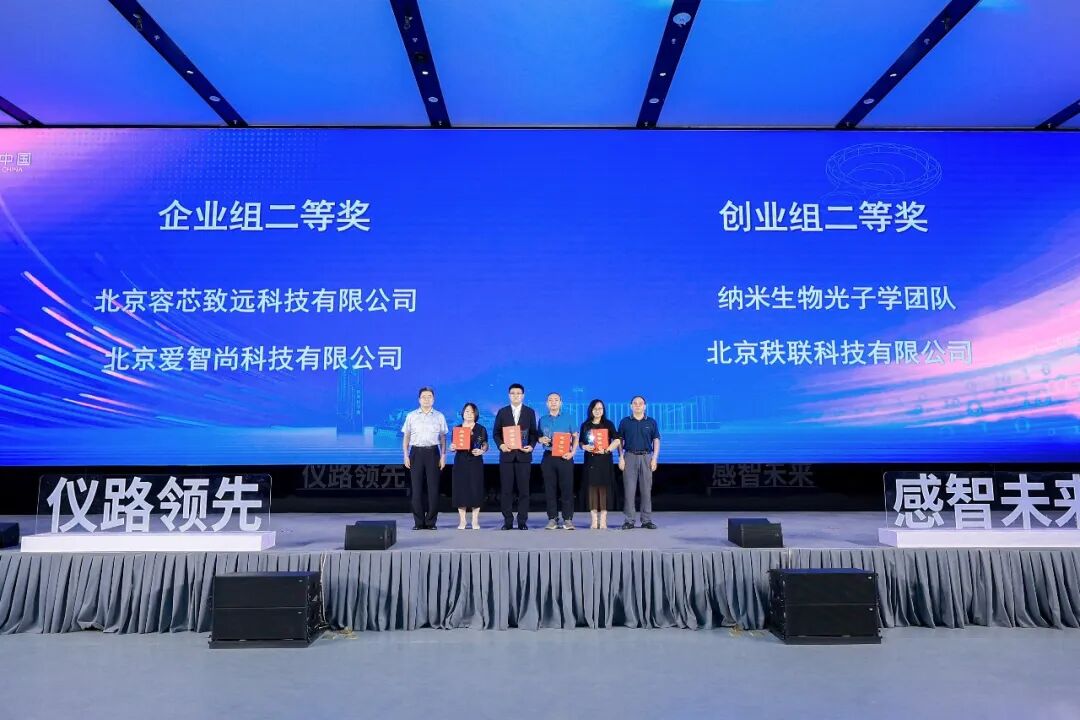
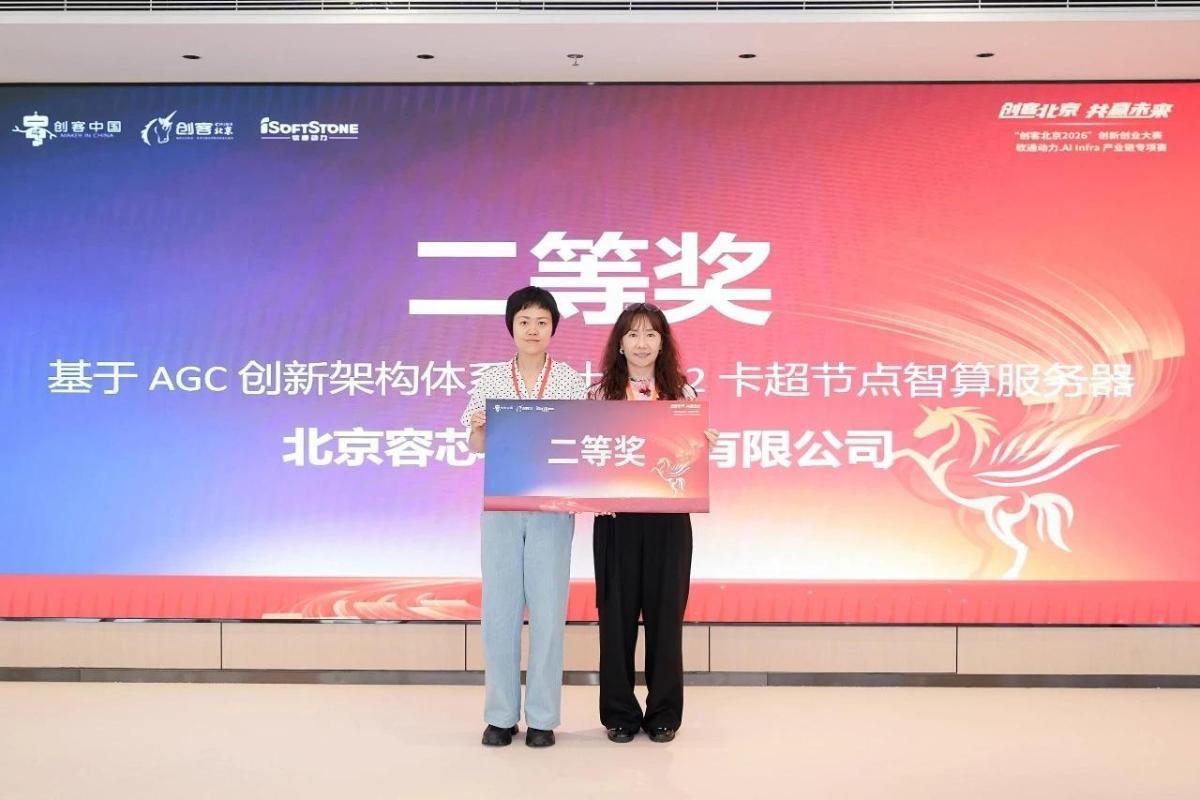
这台32F,近期连续获得两项行业赛事认可——第十一届“创客中国”高端科学仪器装备和传感器中小企业创新创业大赛企业组二等奖,以及“创客北京2026”软通动力·AI Infra产业链专项赛二等奖。获奖项目正是“基于AGC创新架构体系设计的32卡超节点智算服务器”。
评审关注的不是单一参数,而是它在系统架构上的完整度:以GPU为核心,风冷32卡,3D Mesh全对称互联,512GB显存聚合,以及GPU热插拔、GPU-RAID、智能BMC等高可用能力。这些能力组合在一起,让32卡算力在普通机房环境里也能稳定跑起来。这正是它和传统方案拉开差距的地方,也是32F能获奖的原因。
从工程角度看,32卡是一个很微妙的数字。
8卡方案可以用传统PCIe拓扑应付,问题不大。64卡方案通常搭配液冷,走的是旗舰路线。32卡恰好卡在中间:用传统架构,通信瓶颈已经明显;用旗舰方案,成本和部署门槛又太高。
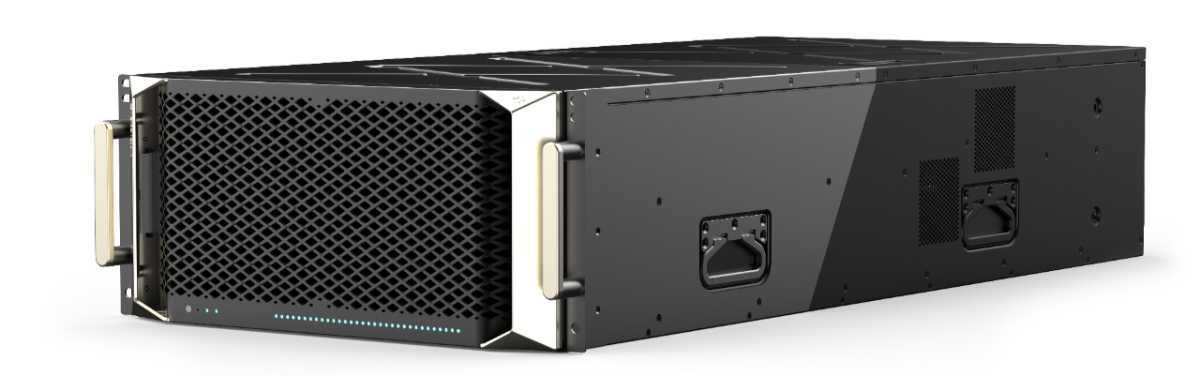
32F的做法是,单机32张GPU,采用3D Mesh全对称互联,让32张GPU在网络拓扑中处于对等位置,通信路径均衡,数据走最短路径到达目的地,不需要经过CPU中转。传统服务器里,GPU之间的数据要经过CPU转发,8卡以内还行,到了32卡,通信等待时间成倍累积,算力利用率快速下滑。3D Mesh拓扑从结构上缓解了这个问题。
显存方面,32F整机提供512GB显存,统一池化管理。大模型整段加载,不用切分。传统多卡方案里,显存是独立的,大模型装不下就得切块分散到不同卡上,跨卡读取的损耗不小。统一池化之后,模型看到的是一整块大显存,加载效率高,推理和微调都更顺。
第一类,自建机房但制冷条件一般的企业。这些企业有算力需求,但机房不是为高密度设备设计的,空调和配电余量有限。32F纯风冷方案,不依赖液冷设施,部署条件比同级别方案低不少。
第二类,需要中型算力池但不想上大规模集群的机构。有些机构不是没有预算,而是不想为了算力专门建一个机房、养一个运维团队。32F模块化设计,维护相对简单,放在现有环境里就能跑。
第三类,做推理服务需要多卡并发但受限于环境的开发团队。推理服务对多卡协同和显存容量有硬性要求,32F的互联和显存能力能支撑中等规模的并发请求,同时部署门槛不高。
如果16F是“算力到现场”,64F是“算力到极致”,那32F就是“算力到合适”。它不追求某一个极限,而是在性能、散热、部署之间做了合理的取舍。
这种定位在宣传上不如其他产品那么有冲击力。但对真正要用它的人来说,这种“恰好”反而更实在。买设备不是买参数,是买“能在我的环境里稳定跑起来”这件事。32F解决的正是这个问题。
下一篇,拆开32F的风冷与模块化设计,看看它怎么在没有液冷的情况下,让32张GPU稳定协同
关于容芯致远